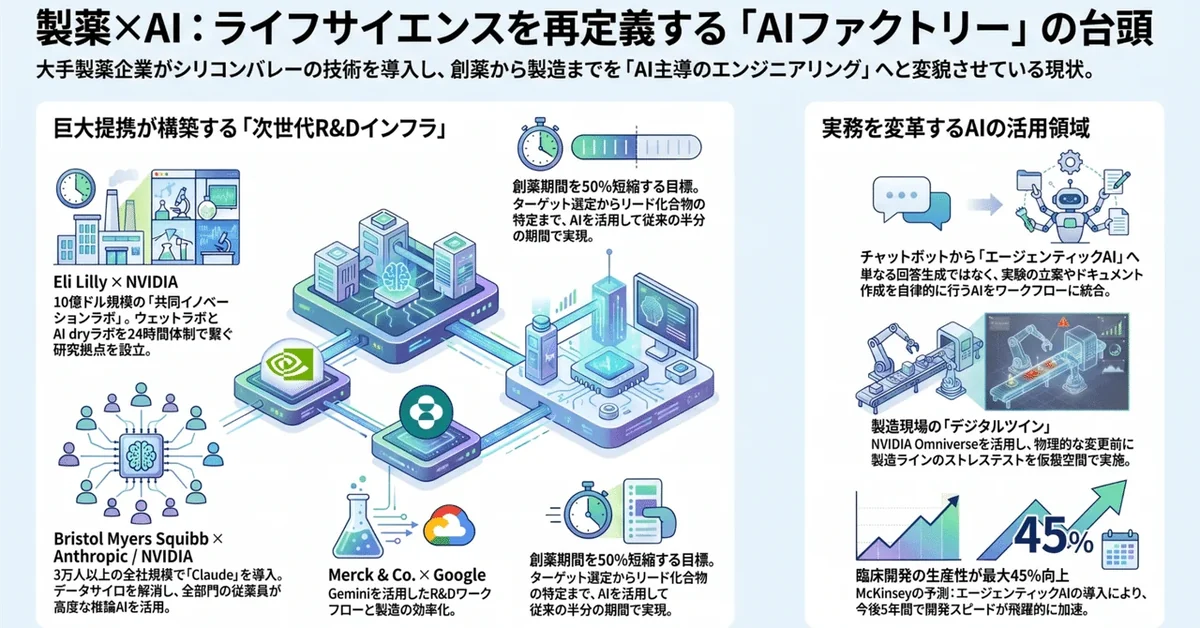
2026年に入り、大手製薬とAI企業の提携が相次いでいる。武田・イーライリリー・メルク・ノボノルディスク・ブリストルマイヤーズスクイブ、アルナイラムなど、総額として数十億ドルに達する規模の資金がAI創薬に流れ込んでいる。
McKinseyが新たに公表したレポート「From linear gates to learning loops」は、AIをただ既存の業務に当てはめても創薬は速くならないと指摘しており、R&Dの仕組みそのものを線形のゲート (Linear gate)から、学びのループ (Learning loops)へと変革しない限りAIの価値は享受できないとしている。
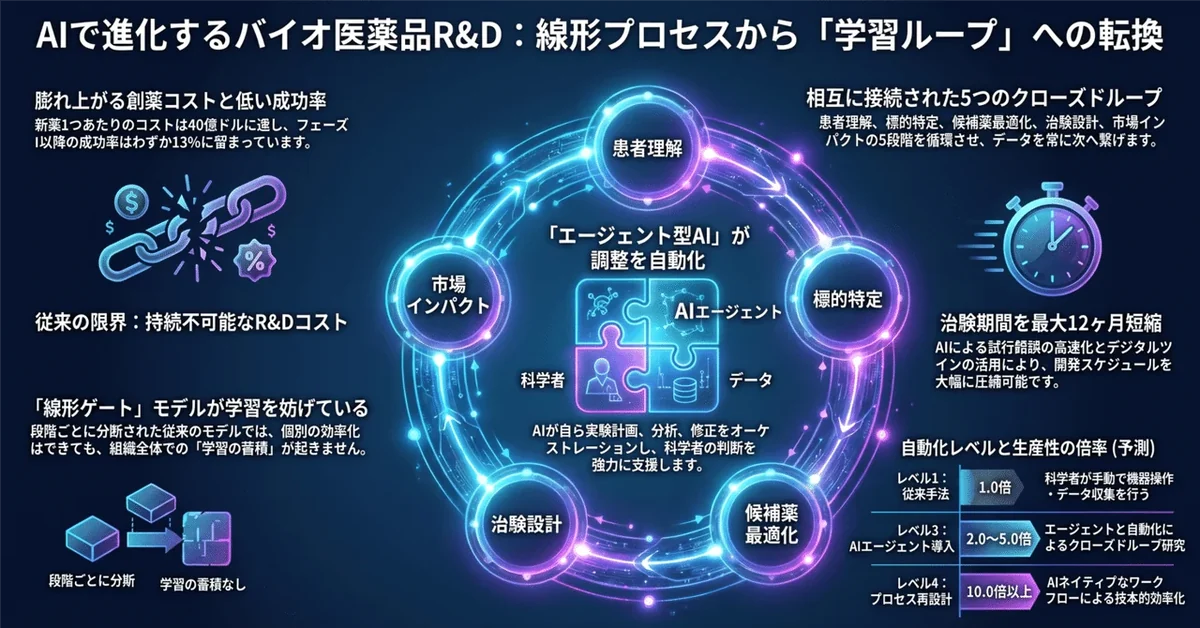
現在の創薬R&Dは、患者・疾患の理解、標的の特定・検証、候補物質の発見・最適化、臨床試験の設計・実施、承認後の価値最大化という五つの意思決定を、一方通行のマイルストン (ステージゲート)として順番に通過させる仕組みになっている。機械学習・生成AI・エージェントAIといった技術は、このステージゲートのひとつひとつを個別に速くすることはできるが、ゲート同士の間に、体系的なフィードバックの経路が存在しない。例えばある治験が、対象患者を広く取りすぎたために失敗しても、その教訓が標的選定の段階まで自動的に遡って反映される仕組みがない。レポート内ではこれを“組織全体を通しての「学習の複利効果(compound learning)」が生み出されていない”と指摘している。
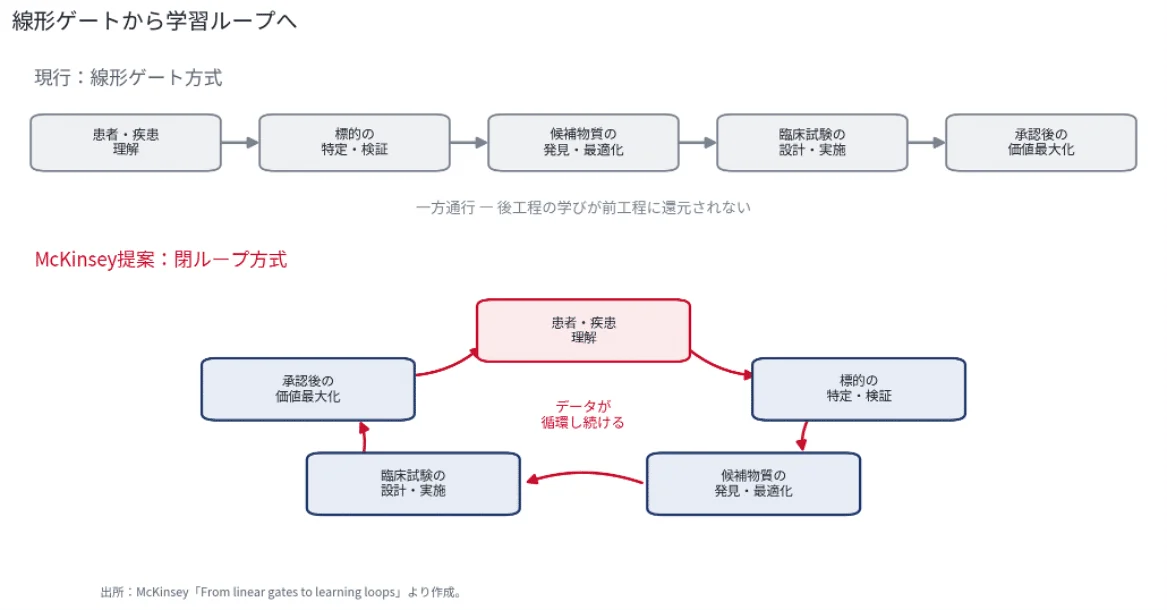
この直線的なプロセスから脱却し、AIの真の価値を引き出すために提唱されているのがR&Dをクローズドループ(Closed-loop)として再編成することである。
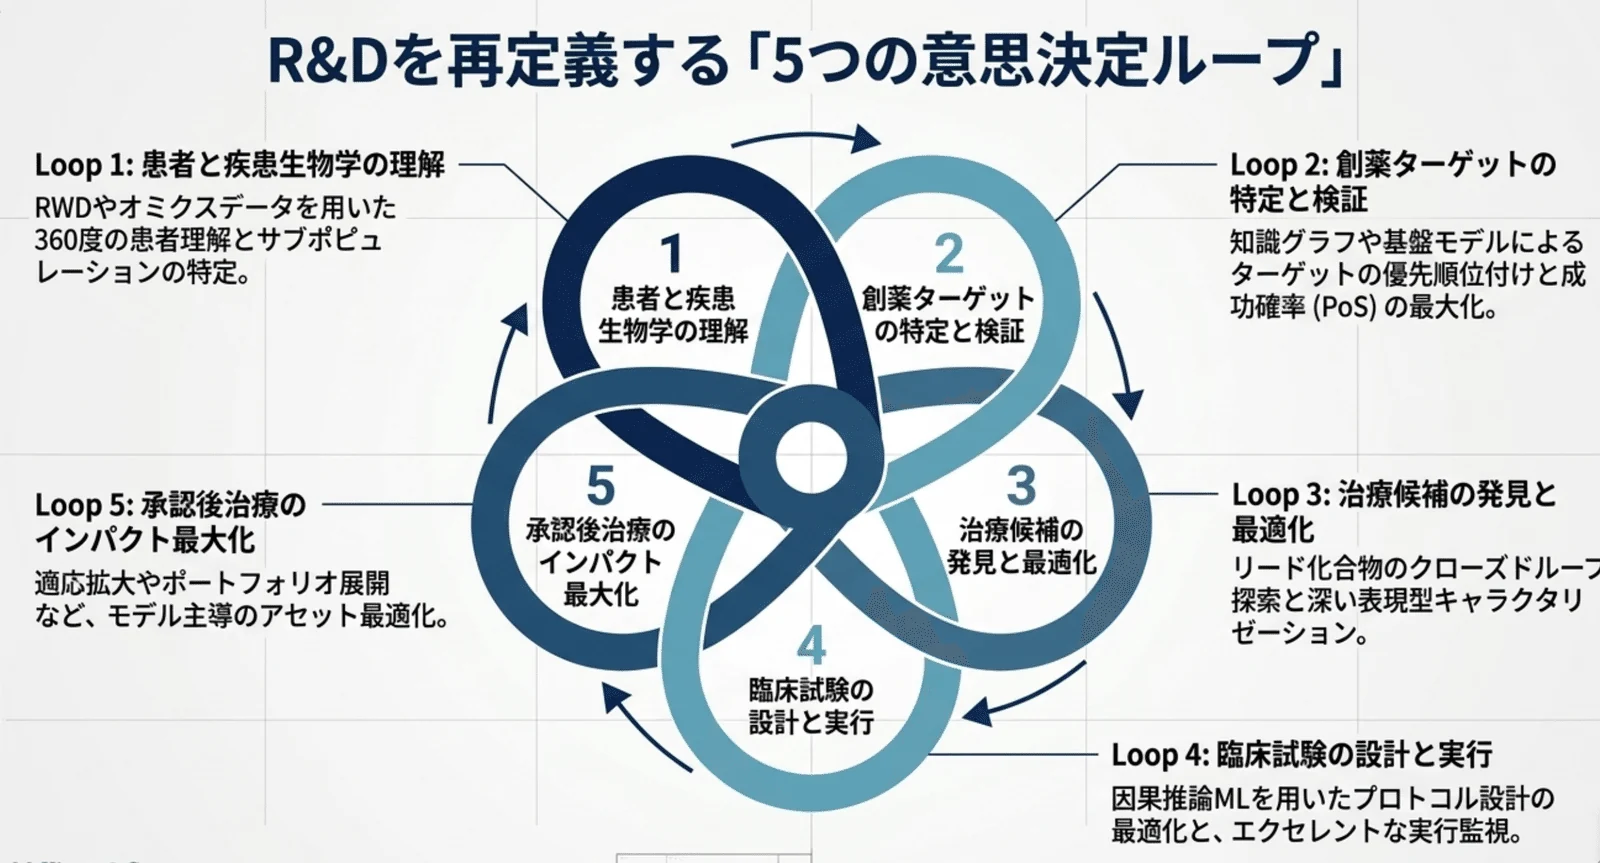
具体的には下記の5つの意思決定ループを回していくことが提言されている。
1. 患者と疾患生物学の理解 :臨床データやリアルワールドデータ(RWD)、ゲノムデータなどを統合し、数週間という短期間で患者の不均一性や疾患の多様性に関する仮説を生成・検証する。これにより、下流のターゲット選択やバイオマーカーの特定をより高い確度で行うことができる。
2. 創薬標的の特定と検証 :生物学的な知識グラフやオミクス解析を活用し、ターゲットと疾患の関係性をマッピングする。最初のループで得られた患者の多様性に関するインサイトを反映させることで、成功確率が最も高いターゲットを効率的に絞り込む。
3. 治療候補の発見と最適化 AI:による予測モデリングと、自動化された実験室(Wet Lab)でのスクリーニングを統合する。デザイン、作成、テスト、分析(DMTA)のサイクルを高速で回し、見込みの薄い候補を早期に排除しながら、有望な分子を反復的に最適化する。
4. 臨床試験の設計と実行 :機械学習やシミュレーションを用いて、対象となる患者集団を絞り込み、プロトコル設計を最適化する。AIは代替の設計シナリオ(適格基準の調整など)を提案し、試験期間を短縮し成功確率を高める。
5. 承認済み治療の患者への影響の最大化: 承認はゴールではなく、継続的な最適化のプロセスの一部と定義される。実臨床データと臨床試験のエビデンスを統合し、新たな適応症の発見や製造戦略(CMC)の最適化を行う。ここで得られたインサイトは、再び最初のループである「新たなターゲット探索」へとフィードバックされる。
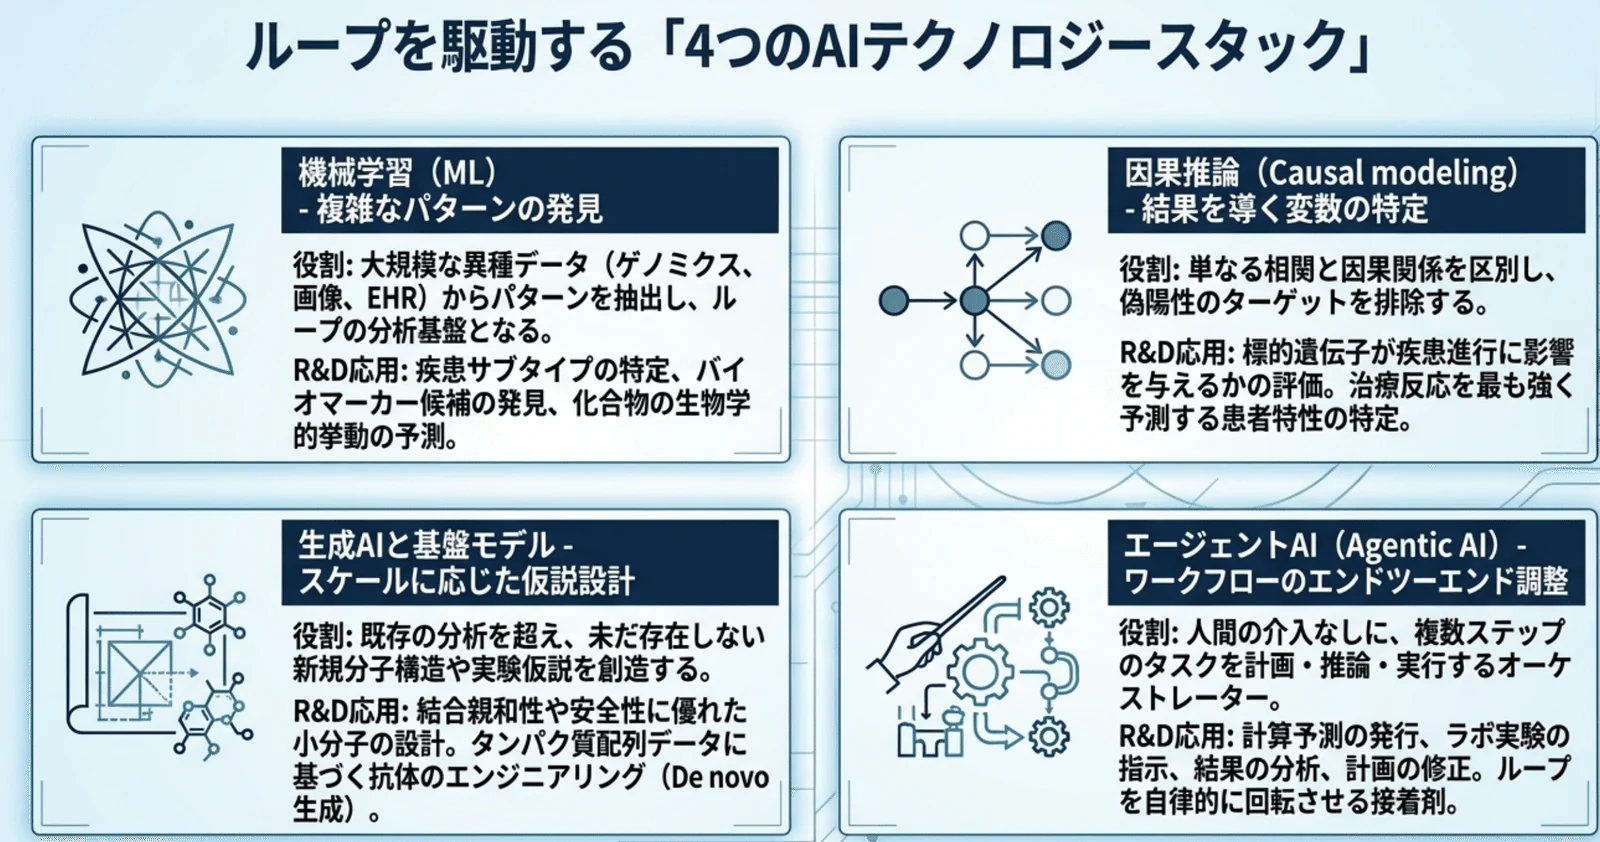
このループを回す技術基盤として、McKinseyは四つの要素を挙げる。
機械学習(ML): 複雑な生物学的データ(ゲノム、画像、電子カルテなど)からパターンを見つけ出す。疾患のサブタイプを特定したり、化合物の生物学的挙動を予測したりする、ループの分析的なバックボーンとなる技術。
因果モデリング(Causal modeling): 単なる相関関係ではなく、結果を直接的に駆動する真の要因を特定する。標的遺伝子が本当に疾患の進行に影響を与えているのか、それとも単なる付随的なバイオマーカーなのかを区別し、後期段階での開発失敗(ターゲット選択のミス)を防ぐ。
生成AIと基盤モデル(Generative AI and foundation models): これまで存在しなかった新規の分子構造や抗体、実験の仮説を大規模に設計する。小分子の結合親和性を最適化したり、タンパク質の構造データを基に抗体のバリアント(変異体)を迅速に探索したりすることが可能になる。
エージェンティックAI(Agentic AI): AIが自律的に計画、推論、実行を行い、研究ワークフロー全体を調整する技術。他の3つのAIを統合し、仮説の生成から実験の提案、結果の解釈までを実行する。 具体例:FutureHouse社が開発した「Robin」は、文献レビューから仮説生成、実験計画までを担い、有望な治療候補の特定に成功している。また、Google DeepMindの「Co-Scientist」も、薬剤の再ポジショニングや併用療法の提案において、実験室でのテストに耐えうる優れた仮説を自律的に生成している。
これらのAIエージェントと完全に自動化された実験室システムが統合されたクローズドループが実現すれば、科学者の生産性は従来の10倍以上へと飛躍的に向上する可能性があると試算されている。しかし、この変革を実現するためには、テクノロジーの導入以上に組織の根本的な改革が不可欠である。企業が取り組むべき主要なステップは以下の通り。
「意思決定」を中心とした組織の再設計:従来の機能や部門ごとの縦割りのプロセスを廃止し、AIによるインサイトに基づいて迅速に判断を下せるよう、ワークフローを再構築する必要がある。
AI人材の内製化:因果モデリングやエージェンティックAIの専門知識を持ち、それをビジネスや科学的インパクトに結びつけられる人材を内部で育成・確保することが求められる。
データ基盤の戦略的構築:AIエンジンはデータの質と連続性に依存する。研究、臨床、製造の各フェーズにまたがる一元化されたデータアーキテクチャを構築することが、継続的な学習ループの基盤となる。